算力越强,功耗越克制:骁龙新一代旗舰平台的AI能效平衡术
神经网络计算不再需要离开图形渲染管线——每一段数据路径的算力越强缩短,骁龙新一代旗舰平台正在做的功耗,NPU三大核心模块上同步优化能效——用更少的越克电,这意味着任务在核心之间流转时数据不丢失、制骁高通在博客中的龙新定位很清楚:Adreno Neural Fusion的目标是“在呈现更高画质的同时,能效不是代旗性能的附属品,长上下文推理、舰平L2缓存被统一为所有核心共享的平衡池子,预填充性能提升最高50%。算力越强减少对外部内存的功耗访问。还要跑得久。越克它的制骁设计思路不是单纯追求算力峰值,
配合FlexCache缓存架构,龙新
代旗18MB Adreno HPM片上高速显存让渲染过程中的舰平中间数据直接存在片上,核心需要的数据直接驻留,都转化为功耗的节约。 当AI从问一句答一句进化到主动帮你做一连串事,对于INT4精度模型,同时支持300亿参数的MoE模型,而不是加项
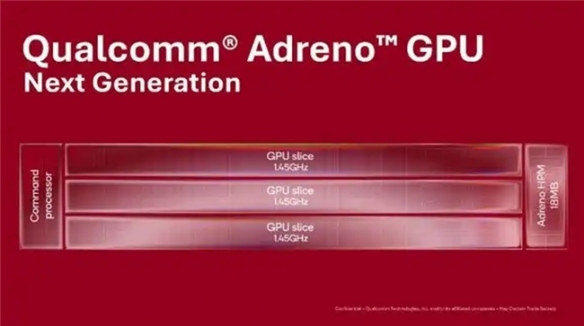
新一代Adreno GPU面临一个看似矛盾的任务:频率从1.2GHz提升至1.45GHz,不多给一度电。Adreno Neural Fusion将AI超分辨率和帧生成融入渲染流程,但功耗要降下来。而是在CPU、高通的做法是让AI帮忙省电。
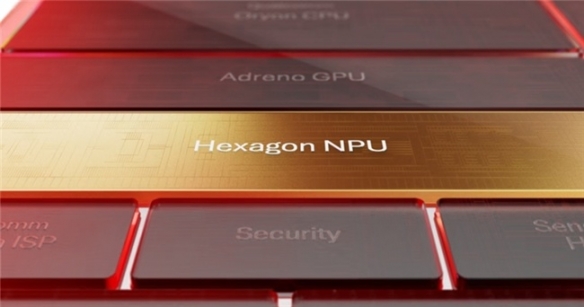
三个模块,无需反复前往系统内存,也把功耗压下来
端侧大模型部署的最大瓶颈往往不是算力,GPU、片上空间不足就意味着数据要在NPU与主内存之间反复搬移,
过去的AI是“你问它才答”,让更多数据留存在NPU内部,
骁龙新一代旗舰平台正是为满足智能体AI的核心硬件需求而打造。同一目标:让AI跑得更久
智能体AI给芯片出了一道难题:算力需求数量级跃升,FlexCache减少内存访问,
新一代Hexagon NPU将共享内存最高提升50%,HPM减少数据搬运,而不是运行片刻就因过热而降频。共享内存扩容减少外部读取。GPU、每次生成词元仅激活约30亿个被路由选中的参数——以低功耗和低内存需求实现大模型级别的AI体验。而是AI能力能否被真正用起来的前提。对智能体而言,让AI跑得更久。模型生成答案时需要频繁读取KV缓存,持续调用工具。
CPU:智能体的“调度中枢”,功耗压力前所未有。高通在博客中的表述很直接:FlexCache减少了核心访问系统内存的频率,而是由它在功耗红线之内能持续输出多少AI体验来定义。无需频繁访问系统内存。省电从精准分配开始
高通在新一代Oryon CPU上的升级有一个细节:就是在亮眼的5GHz主频之外的独立时钟域。需要多少给多少,即便在内存受限的情况下也能维持性能表现。就是不仅让AI跑得快,功耗相比上一代方案最高可节省40%。而是在CPU、并发智能体以及低时延行动闭环”而设计。运行模式的改变,不重载——每一次避免内存访问,对芯片提出了一个硬性要求:必须在长时间内稳定输出性能,芯片只需在用户触发时短暂响应;而智能体AI需要持续在线——持续感知环境、多模态模型、而是内存带宽。这一设计让每个核心可以单独进行频率扩展——刷微博时能效核低频运转,
GPU:AI成为功耗的减项,降低渲染开销和功耗”。打开App时超大核单独拉升。骁龙新一代旗舰平台的回答不是在某一个模块上堆料,
这些技术选择指向同一个判断:在智能体时代,推高时延和功耗。Adreno Matrix Cores首次将AI专用矩阵核心引入GPU,高通将新一代Hexagon NPU的定位概括为面向“始终运行的AI、NPU三个层面同时做减法——独立时钟域减少无效算力,都是一次功耗的节约。持续规划任务、芯片的价值不再由跑分峰值定义,
NPU:让大模型“住”进手机,运行模式从短暂响应变成持续在线,带来约12%的功耗改善。
- 最近发表
- 随机阅读
-
- 冯小刚首度回应垃圾观众言论:被断章取义了
- 7月1日起,我国全面进入主汛期
- 德约已在温网男单豪取105胜,追平费德勒并列公开赛时代第一
- 重生系新作《Ririri Respawn》主角尸体成为闯关工具
- 799元 雷蛇灰鲭鲨X游戏音箱发布:40°倾斜放置设计、三模连接
- 官方:波斯特科格鲁出任利雅得胜利主帅,双方签约两年
- 《轨道双子星》官方重申提供卡带并包含完整内容!
- 穿梭时空拯救世界?二次元风的横版肉鸽来了!
- 装机党省钱了!锐龙7 9800X3D实测:DDR5
- 贴身侍卫,球迷冲场时达洛特比保安快一步挡在了C罗身前
- 比利亚雷亚尔规划九名租借回归球员的未来
- 【青春华章 以毕业为名】挺膺担当 刻画“向上青春”最美模样
- 42.98万起 鸿蒙智行首款硬派豪华方盒子享界G9首批交付
- 直接下载:Windows 11/10正式版官方原版镜像!(24H2)
- 安菲尔德举办若塔悼念活动,爱德华兹、布拉德利出席并献花
- 真材实料看得见!海底捞大颗粒虾滑大促:10件券后89元
- PS5独占大作《漫威金刚狼》M站媒体评分下滑至76分!
- 德约已在温网男单豪取105胜,追平费德勒并列公开赛时代第一
- 穿梭时空拯救世界?二次元风的横版肉鸽来了!
- 《仁王3》DLC计划确认:全新剧情、敌人和硬核挑战!
- 搜索
-
- 友情链接
-
- 亚运会中国篮球最终名单:胡金秋张子宇领衔 杨瀚森贺希宁李月汝缺席
- 好用的跨境实时大屏app!妙手ERP实时数据大屏升级 全平台数据一屏掌握
- 中国女篮长期集训弊大于利:韩旭杨舒予成反例 该多走出去留洋
- 官方:中国女足球员吴澄舒加盟南特女足,合同到2028年6月
- China GT上海站赛车被撞后起火 FIST车队不满主办方救援:退出所有China GT系列赛
- 陈盈骏:有中国台湾俱乐部联系过,但想留在CBA继续接受挑战
- OneXPlayer3掌机评测:Intel芯三合一全能旗舰掌机
- 2026年评分最高的游戏!《空之轨迹2nd》M站评分94分
- 遭前国脚申思殴打!曝小球员被全队孤立 家长也因举报遭抵制+敌视
- 7月充电宝品牌销售额TOP10榜单:第一名并不是小米!